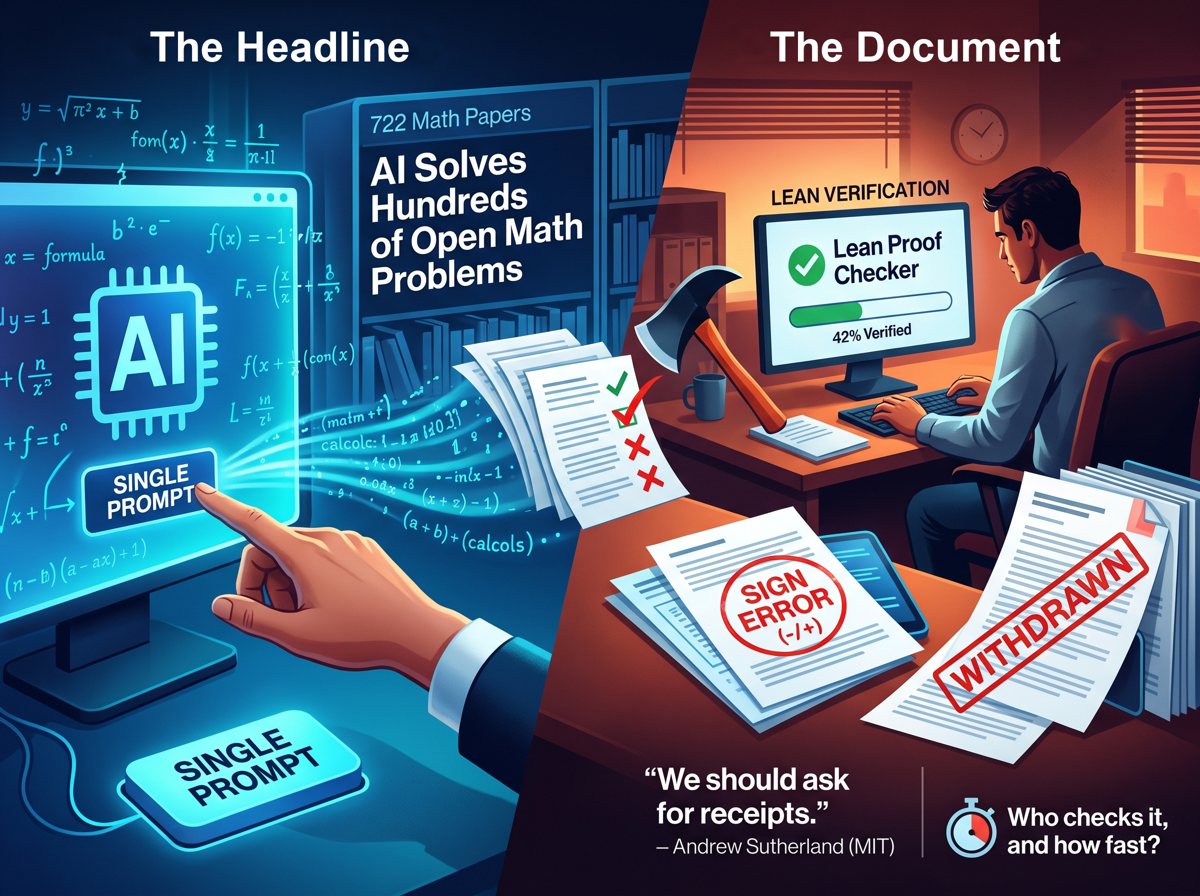
Il titolo che è circolato
L'AI di OpenAI risolve centinaia di problemi aperti della matematica, con un solo prompt.
Che cosa dice il documento
La sera del 6 ottobre OpenAI, l'azienda che sviluppa ChatGPT, ha pubblicato su GitHub 722 manoscritti di matematica, raccolti in 372 famiglie di risultati e prodotti da un modello interno che non è in commercio. Secondo il repository, al modello sono stati posti circa 4.000 problemi, e in media ogni risultato ha richiesto il calcolo equivalente a circa tre ore di ragionamento di ChatGPT Pro. Il post che accompagna la pubblicazione è breve: annuncia i risultati, le dimostrazioni formalizzate in Lean, un linguaggio in cui un computer controlla ogni passaggio di un ragionamento, e dieci sintesi del ragionamento del modello.
Il repository è più prudente del titolo che è girato. Scrive che la raccolta contiene risultati a diversi stadi di verifica, e che alcuni di quelli non formalizzati potrebbero avere dei problemi. Oggi i risultati principali verificati in Lean sono 300 su 719, circa il 42 per cento. Due dei risultati più ambiziosi, sulla funzione zeta di Riemann e sulla congettura di Hodge, non sono stati ottenuti con la procedura standard, e il testo di uno dei due è stato rivisto da persone per renderlo leggibile.
Il 7 ottobre, il giorno dopo, la cronologia del repository registra i primi ritiri. Un errore di segno invalida un argomento in uno dei manoscritti e la costruzione su cui se ne reggevano altri due. Sono stati ritirati tutti e tre, compreso uno sulla congettura razionale di Hodge per i prodotti di superfici K3. Nello stesso aggiornamento quattordici manoscritti sono stati corretti, e tredici hanno aggiornato le citazioni dei lavori collegati.
La frase del singolo prompt non è nel repository. L'ha detta un portavoce a Scientific American: quasi tutti i risultati sarebbero nati da un'unica richiesta affidata a un unico agente. Lo stesso portavoce ha aggiunto che alcuni potrebbero aver richiesto più tentativi, e che molti non sono ancora stati compresi dai matematici dell'azienda. Andrew Sutherland, matematico del MIT, ha chiesto di considerare quell'affermazione non verificata finché il modello non sarà accessibile e i risultati riproducibili: «We should ask for receipts», bisogna chiedere le ricevute.
Che cosa non sappiamo
Quanti dei risultati non ancora verificati in Lean, più della metà, reggeranno al controllo dei matematici. Ci vorranno mesi, e Scientific American riporta giudizi molto diversi sulla leggibilità dei testi.
Quali prompt sono stati usati, e quali dei circa 4.000 problemi il modello non ha risolto. Il gruppo consultivo di matematici che OpenAI ha riunito a settembre raccomanda di rendere pubblici il modello, il prompt esatto e il calcolo di ciascun risultato. OpenAI ha pubblicato solo il calcolo medio, e ha detto a Scientific American di non essere vincolata da quelle raccomandazioni.
Chi ha scelto i problemi. Diversi matematici sentiti da Scientific American sospettano che sia stato il modello stesso a proporli; OpenAI non ha risposto alla domanda.
Chi ha trovato l'errore dei tre ritiri. Scientific American scrive che l'hanno scoperto degli esperti; il repository non lo dice.
Il capitolo del libro
Benvenuti nell'era